
10月中旬,爱芯元智在CIIF 2026发布AX8860大算力边端AI芯片系列;几乎同一时间,以开发板和开源硬件闻名的Sipeed(矽速科技)把同一颗AX8860P塞进一台只有Mac mini一半大小、标称典型功耗40W的迷你主机MaixStation,并在官网直接发问:“DGX Spark是唯一的答案吗?”
这不是一次常规新品露出,而是一次明确的价格战与叙事战。Sipeed把128GB LPDDR5X、273GB/s带宽、256 TOPS FP4、16核Arm Cortex-A55,包装成“从3英寸模块到机架集群”的本地AI自由方案,并宣称2026年底登陆Kickstarter、128GB版本目标价约3999美元。
从“云端独大”到“桌面本地AI”
一场AI推理范式的迁移
过去,AI计算的重心几乎完全落在云端数据中心:模型训练与推理都在由成千上万张GPU组成的集群中完成,终端更多承担数据采集和结果展示的角色。
如今,在隐私合规、实时性刚需与长期成本三重约束的共同推动下,AI推理正加速从集中式云端向分布式终端迁移。也正因如此,“桌面本地AI”不再只是极客圈层的玩具,而是逐渐成为主流厂商竞相布局的一条新赛道。
此前,本地AI硬件面临着一个现实困境:普通用户要么买昂贵的GPU工作站,要么把数据和任务交给云。GPU工作站虽然能提供强大的算力和高带宽,但动辄数万元的成本让普通用户望而却步;云端推理虽降低了硬件门槛,却牺牲了数据隐私和实时性,尤其不适合对安全性要求高的场景。归根结底,这背后是算力、成本与隐私之间难以兼顾的权衡。
眼下,三重刚性压力正在打破原有平衡。合规红线持续收紧,敏感场景数据不得上传云端,本地推理直接从“可选方案”升级为“唯一合规解”;物理延迟存在天然上限,要求毫秒级响应的场景,云端网络往返延迟根本无法达标;同时云端推理成本持续走高,大模型token调用量爆发式增长,同步推高了算力、带宽与服务器的综合开销。
与此同时,负载形态也在发生变化。Agent、编程助手、视频生成、机器人VLA等新一代应用,普遍要求低时延、数据隐私和可控成本,需要模型常驻设备本地随叫随到,而非每次请求都往返云端。
需求侧的迫切刚需,恰好撞上了技术供给侧的成熟窗口。开放权重模型快速迭代,4bit/FP4量化让70B级模型的本地部署从“不可能”变成“勉强可行”;面向终端原生设计的小参数模型与蒸馏、剪枝、稀疏化等技术,把可用性能压缩到中低端NPU也能承载的体量;端侧芯片的NPU算力与能效比同步跃升,为本地推理提供了硬件底座。
IDC数据显示,2026年第二季度全球终端侧AI处理的算力占比首次突破52%,越过“云端依赖”与“本地分担”的临界点。与此同时,2026年Q1全球云端AI芯片出货量同比增长仅12%,较2025年同期35%的增速明显放缓;而边缘AI芯片出货量同比大增45%。
IDC进一步预测,到2030年将有50%的企业AI推理任务从云端下移到网端设备或边缘节点本地完成。多家市场研究机构的数据也显示,消费端同样在提速,2026年AI PC与AI手机的渗透率双双跨过50%临界线。
当AI竞争的焦点从训练转向推理,当模型权重须完整驻留设备本地,桌面级本地AI计算机这一全新品类正在加速成形。从NVIDIA亲自下场推出DGX Spark,到苹果把Mac Studio的统一内存拉满至192GB,再到AMD将LPDDR5X高带宽内存塞进Ryzen AI Max/Halo迷你主机,全球科技巨头都在向同一个方向发力。而MaixStation,也正是这条赛道里的核心入局者。
MaixStation真正卖的不是TOPS
而是“带宽利用率×内存容量×功耗”
MaixStation的核心是爱芯元智AX8860P。6nm制程,16核Cortex-A55,自研NPU标称256 TOPS混合精度算力,原生支持FP4且无稀疏性,最高128GB LPDDR5X,273 GB/s带宽,支持PCIe 5.0和AXLink级联,并支持vLLM、SGLang、PyTorch等框架。
在此之上,Sipeed进一步把整机做到110×110×30mm、363cm³,提供USB-C PD供电、USB 3.0、10G SFP+和模式切换,并预置Qwen模型、Web UI与OpenAI/Anthropic兼容API。换句话说,它交付的不是一块待开发的板子,而是一台通电即用的小型AI主机。
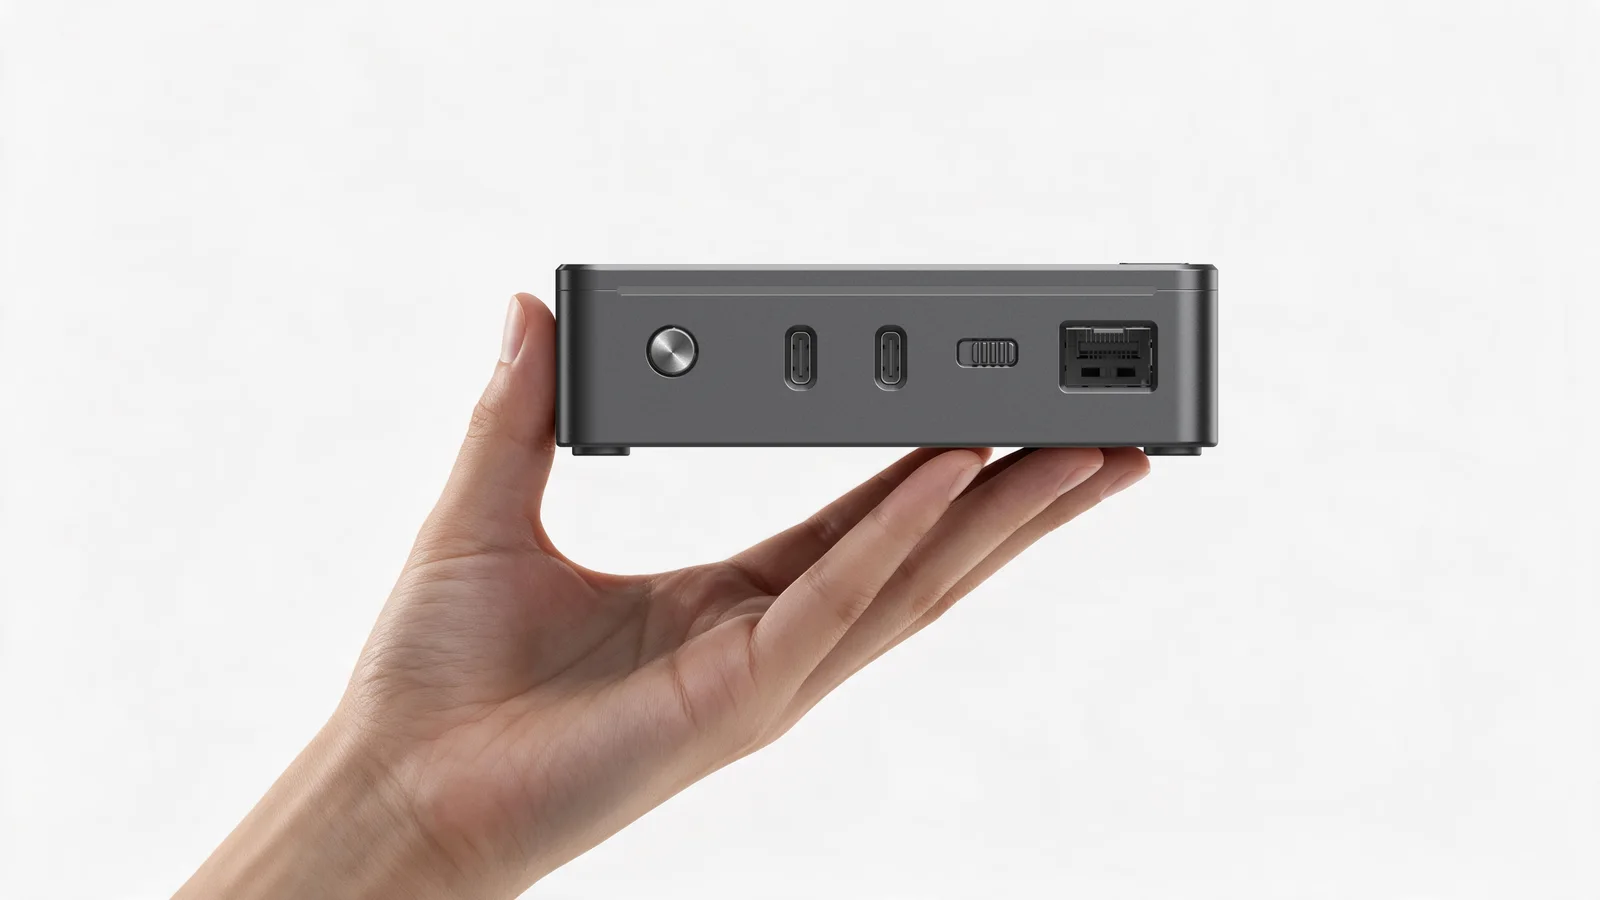
图源:Sipeed官网
单看TOPS数字,MaixStation远不及DGX Spark搭载的GB10所宣传的“1000 TOPS”量级。但Sipeed在官方页面上给出了关键解释:DGX Spark的1000 TOPS是稀疏FP4算力,稠密算力纸面约为500 TOPS,而真实模型无法充分利用稀疏性,实际运行时“只用上了其中一小部分”。反过来,AX8860P虽然只有256 TOPS,却能把更高比例的算力资源转化为实际的prefill处理速度。
进入decode阶段后,当二者的内存带宽同为273GB/s,此时性能的胜负就此取决于谁的架构能把带宽推到多接近理论上限。毕竟在大模型decode阶段,带宽决定上限,架构效率决定离上限有多近。每生成一个token都要把模型权重完整读一遍,而MaixStation恰恰能把这273GB/s的带宽潜力挖掘得更充分、用得更饱满。
Sipeed据此给出对比:运行27B模型时,MaixStation的预填充速度比DGX Spark快10%,解码速度快10%。不过需注意的是,其官网图表明示AX8860P仍在调优、实色为当前保守实测。
另一方面,边缘AI市场从来不是缺一颗标称TOPS很高的芯片,而是缺能长期维护的驱动、算子、量化工具、模型并行框架和故障诊断体系。对客户来说,迁移到一颗新NPU意味着重新评估模型,把PyTorch模型转成NPU计算图、补算子、做量化和编译;一旦出现不支持算子回退到CPU,实测性能会远低于峰值算力。
Sipeed显然明白这一点,因此把软件栈当成卖点而不是附注:vLLM/SGLang经由定制硬件加速后端运行,算子用AXDSL编写;官方称将开源已支持模型的AXDSL kernel与开发工具,并推进AX8860 SDK开源与上游化;整机预装Debian 13/Linux 6.18,直接跑Hugging Face模型,提供OpenAI/Anthropic兼容接口。
这套打法的关键不是“兼容”两个字,而是能否让开发者的技术栈不变:模型从云端迁到本地,业务代码不改;算子缺口由开源社区和代码agent补齐;企业沿同一技术路线从32GB扩展到512GB乃至机架集群,无需反复面对“算力选择题”。
写在最后
站在行业转折的节点回望,MaixStation的出现,恰恰把端侧大模型推理的竞争,拉进了一个更贴近真实用户需求的“务实阶段”。
此前赛道的竞争,核心是围绕着“能不能在本地跑一个模型”展开,参数规模、TOPS算力、内存容量是各家比拼的核心叙事筹码。但当128GB统一内存开始下探到4000美元以下的消费级设备中,行业的核心瓶颈早已不再是硬件容量的有无,而是实实在在的落地使用体验。
AX8860P和MaixStation的价值,是把本地大模型硬件的竞争拉回工程本质:在给定内存容量和带宽下,谁能把更多算力变成有效吞吐;在给定价格下,谁能把开发者迁移成本降到接近零;在给定功耗下,谁能让模型离数据更近。
从“能跑起来”到“跑得好用”,行业的评价标尺已然落到了每一次点击、每一秒生成的真实体验里。
目前,Sipeed推出的搭载爱芯元智AX8860P芯片的MaixStation迷你AI计算机现已开启意向预订,相关详情可访问官方专属页面了解:https://sipeed.com/maixstation/